造出Transformer架构(变换器架构)的那个人,跑去OpenAI(AI研发公司)了。
6月17号,Noam Shazeer(诺阿姆·沙泽尔)官宣加入OpenAI,职位是架构研究负责人。
Sam Altman(山姆·奥特曼)坦言,从OpenAI成立那天起,他就想跟这个人合作,整整等了十年。
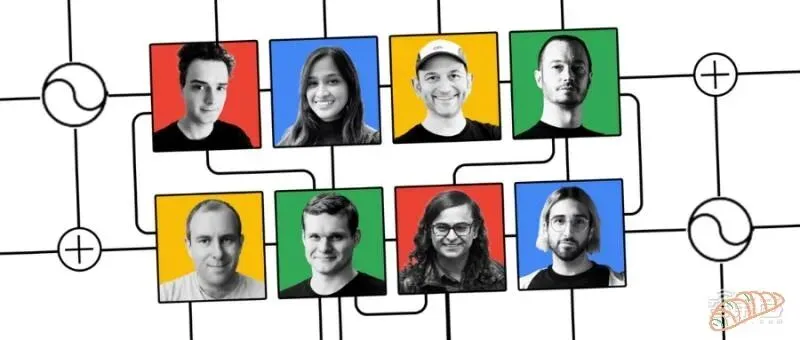
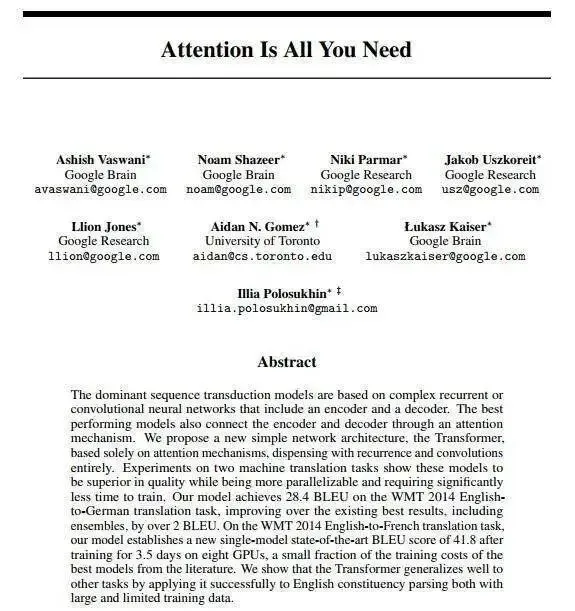
2017年,Google(谷歌)八位研究员发布了一篇封神论文,标题叫《Attention Is All You Need(注意力即是全部)》。
直译过来就是:注意力,就够了。
标题口气大得离谱,但他们真的做到了。
这篇论文提出了Transformer架构。
如今我们熟知的 GPT、ChatGPT、文心一言、通义千问、DeepSeek(深度求索)、Claude,全部都是在这个架构的基础上搭建出来的。
而Noam Shazeer,正是八位作者里贡献最大、最核心的那位。
在谷歌内部,他甚至被同事称为AI圈的“巫师”。
谷歌曾经花27亿美元重金把他挽留回来,可不到两年,他再次选择离开。
当时 OpenAI 和马斯克的 xAI(马斯克AI公司) 两大巨头疯狂争抢,最终他选择加入OpenAI。
今天不聊人事八卦,我们聊点更硬核、更实用的:
Transformer 到底是什么?为什么它值几十亿?和我们普通人有什么关系?
01 在Transformer出现之前,AI有多笨
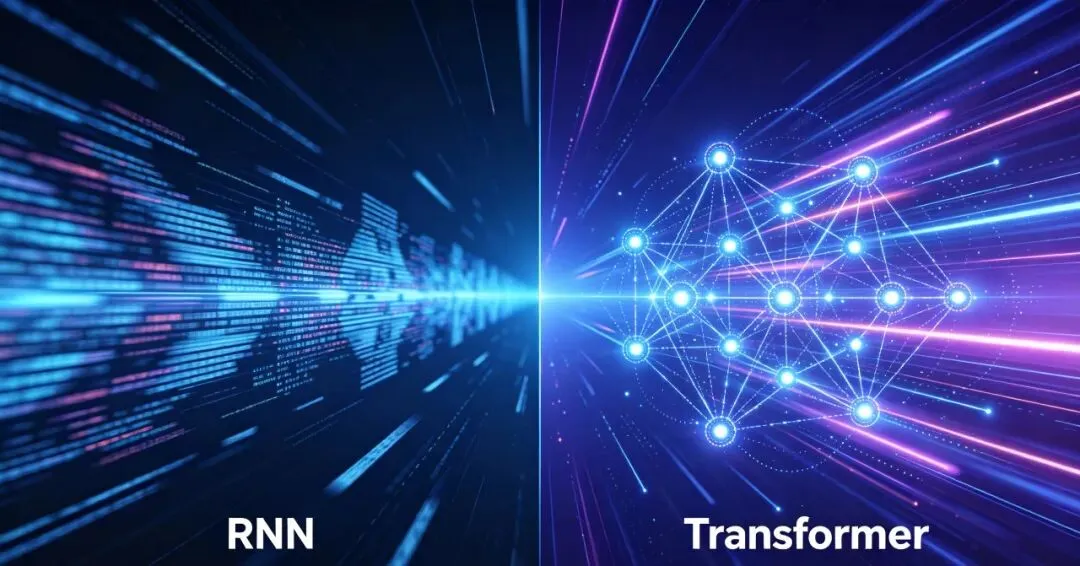
在Transformer诞生前,AI处理文字、理解语言,靠的是 RNN(循环神经网络)。
它的工作方式非常笨拙:从左到右,一个字、一个字地读。
你可以想象一下:
让你逐字逐句读完一篇五千字的文章,等你读到最后一段,大概率早就忘了第一段写了什么。
RNN 也是一样。
文本一旦变长,前面的信息直接丢失。
行业里叫「长距离依赖问题」,大白话就是:前面的记不住,后面的跟不上,全程迷路。
更致命的是:RNN 无法并行计算。
一万个字,就必须老老实实从头算到尾,不能同时处理、不能提速。
这也是为什么早年的AI,又慢、又笨、记不住长内容。
02 Transformer,彻底改写AI规则
Transformer 做了一个颠覆性的改变:
不再逐字阅读,而是一眼看完一整句话、一整段文字。
然后通过注意力机制,自动判断:
这句话里,哪些词关系最紧密、最有关联?
举个经典例子:
“它把杯子放到桌子上,因为它太重了。”
我们人一眼就能分辨:
第二个「它」指代杯子,不是桌子。
我们不需要重读全文,靠的就是注意力筛选重点。
Transformer 就是复刻了人类的这种能力:
让每一个字,和全文所有字建立关联;
关联越强,分配的注意力权重越高;关联越弱,直接降低关注度。
最关键的是:它支持全程并行计算。
从前 RNN 一万个字排队计算,
现在 Transformer 一次性全部算完。
速度直接飞跃式提升。
通俗比喻:
RNN 像老和尚逐字念经,死板又缓慢;
Transformer 像成年人看报纸,一眼扫完全文、瞬间抓取重点。
03 为什么这个人值27亿美元?
2017年之前,整个AI行业都认为:
想要AI理解语言,必须靠复杂结构、叠加记忆模块。
直到这篇论文颠覆所有人认知:
不用花里胡哨,只要注意力机制,就足够支撑AI理解语言。
事实证明,它真的够了。
从2017年至今,全球所有主流大模型,底层清一色全是 Transformer。
GPT全系、Google Gemini、Meta Llama、DeepSeek、Claude,无一例外。
不仅如此,Noam Shazeer 同年还开创了 MoE(混合专家模型)。
现在的 GPT-4、DeepSeek-V3 等顶级模型,全部依赖 MoE 架构提速增效。
简单说:
现代AI的两大基石:Transformer + MoE,都是这个人奠基的。
这也是为什么谷歌两次招揽、两次留不住,Altman 甘愿等他十年。
04 Transformer,和普通人有什么关系?
你可能觉得底层架构离自己很远。
其实你每天都在反复使用。
你用 ChatGPT 写文案、
用 DeepSeek 查资料、
用 Kimi 读长文档、
用所有AI对话工具……
后台跑的全部都是 Transformer。
看懂它,你就能看懂AI的所有优缺点:
AI为什么行文无比流畅?
因为 Transformer 天生擅长概率预测下一个字词。
AI为什么经常一本正经胡说八道?
因为它不会真正理解语义,只是在匹配大数据里的高频语序。
它不是在思考,它是在精准接龙。
05 Transformer,天生自带三大硬伤
没有任何技术是完美的,Transformer 有三个行业皆知、但很少对外科普的短板。
第一:长文本记忆能力严重不足。
哪怕现在AI都卷到 128K、200K(12.8万、20万字)超长上下文窗口。
但文本越长,分配给每个字词的注意力越稀薄。
就像盯着整面墙看,最终哪里都看不清楚。
窗口大,不代表真记住,很多时候只是“假装记住”。
第二:没有真正的推理能力。
Transformer 全程依靠概率拟合,而非逻辑推导。
简单问题能答对,稍微复杂的数理、逻辑闭环问题,就容易崩坏、乱答。
它是模仿答案,不是推演过程。
第三:多轮对话状态追踪差。
聊十几二十轮之后,AI很容易忘掉前文约定、前期信息。
这不是 bug(程序漏洞),是架构天生缺陷:
每一次回答,都是一次独立预测,没有持续记忆状态。
06 MoE,唯一的补救方案,但无法根治问题
现在行业通用的解决方案,就是 Noam Shazeer 自创的 MoE 混合专家模型。
旧模型:一个模型包揽所有任务,笨重、算力消耗巨大。
MoE模型:拆分成无数个“专家模块”,只用哪个、激活哪个。
模型可以做得极大,但每次运行只消耗少量算力。
GPT-4、Gemini、DeepSeek-V3 全部在用这套方案。
但 MoE 只能优化速度、降低成本、放大模型体量。
它解决不了记忆弱、不会推理、状态丢失的底层架构缺陷。
07 AI的下一个时代,即将开启
这次 Shazeer 入驻 OpenAI,不是写代码,不是做迭代。
他的核心任务只有一个:
寻找 Transformer 的替代者,研发下一代AI底层架构。
整个AI行业已经达成共识:
单纯堆参数、堆数据、堆 GPU(运算显卡),收益越来越低。
GPT3到GPT4是质的飞跃,
GPT4到后续版本,提升越来越平缓。
规模定律 Scaling Law(规模缩放定律)正在失效。
未来的突破,不再是“把模型做大”,
而是换掉底层架构,解决三大终极问题:
长文本永久记忆、
真正的逻辑推理、
持续稳定的对话状态追踪。
最懂 Transformer 缺陷的人,就是亲手创造它的人。
由他来颠覆旧时代、开启新时代,再合适不过。
2017年,一篇15页的论文,八个研究者,
彻底把AI从“逐字拼读”带进了“全局感知”的时代。
未来三年,或许就是后 Transformer 时代全面到来的时候。
你觉得,Transformer 还能统治AI多久?
欢迎评论区聊聊。
 10个月宝宝每天需要喝多少奶粉?